LambdaLab
Curso práctico de Big Data con procesamiento distribuido, streaming, observabilidad y BI/ML distribuido.
LambdaLab es un entorno integrado de procesamiento distribuido en batch y streaming con Spark y Kafka, al estilo Uber. Permite construir pipelines de datos, gestionar almacenamiento analítico en Parquet, aplicar observabilidad y desarrollar soluciones de BI/ML distribuido mediante laboratorios reproducibles basados en Docker. Incluye documentación publicada y puede ser personalizado por cada equipo para adaptarlo a su proyecto específico.
Producto del curso
Producto del curso = Producto U3:
Sistema Big Data distribuido end-to-end que integra procesamiento batch,
procesamiento streaming, analítica/ML, observabilidad y visualización BI para
la toma de decisiones.
Resultado esperado del curso:
Al finalizar el curso, el estudiante implementa, integra y sustenta una solución Big Data end-to-end que combina pipelines batch distribuidos, ingesta y procesamiento de eventos en tiempo real, analítica/ML a escala, observabilidad técnica y visualización BI. La solución debe ejecutarse de forma reproducible, mostrar evidencias de ejecución, reportar métricas técnicas y del modelo, y demostrar valor para la toma de decisiones.
Contenido
U1: Arquitecturas Big Data y ETL batch distribuido
Producto U1: pipeline batch de ETL distribuido con salidas analíticas en Parquet listas para BI/ML.
Resultado esperado U1: el estudiante construye un pipeline batch reproducible con procesamiento distribuido, aplica transformaciones sobre datos a escala, valida la calidad básica de los datos, organiza salidas en formatos analíticos como Parquet y deja un dataset preparado para consumo BI/ML.
- Sesión 1: Arquitectura Big Data.
- Sesión 2: Fundamentos Apache Spark.
- Sesión 3: Procesamiento batch con Spark: ETL distribuido.
- Sesión 4: Almacenamiento, HDFS y formatos.
- Sesión 5: Evaluación U1.
U2: Sistema Big Data en tiempo real: streaming, operación y ML a escala
Producto U2: pipeline streaming en Spark para ML/BI a escala y en tiempo real.
Resultado esperado U2: el estudiante implementa un pipeline Big Data en tiempo real que integra ingesta de eventos mediante Kafka, procesamiento distribuido con Spark Structured Streaming, observabilidad y estimación de costos operacionales. Además, entrena, evalúa, guarda y reutiliza modelos distribuidos con Spark MLlib para inferencia batch y/o streaming, seleccionando mejores configuraciones mediante experimentación distribuida.
- Sesión 6: Ingesta en tiempo real (Kafka).
- Sesión 7: Procesamiento en Streaming con Spark.
- Sesión 8: Observabilidad (Grafana) y Costos:
08_obs_basico.ipynbcomo previo,08_observabilidad_pipeline_kafka_spark.ipynbcomo práctica principal y08_costos_escalado.mdcomo segunda parte. - Sesión 9: ML distribuido: regresión con MLlib (modelo entrenado, evaluado y guardado).
- Sesión 10: Series de tiempo e inferencia en streaming (aplicación del modelo guardado sobre datos batch y/o Kafka streaming).
- Sesión 11: Tuning y experimentación distribuida (mejor modelo seleccionado con validación distribuida).
- Sesión 12: Evaluación U2.
U3: Integración y sustentación del producto final
Producto U3 / producto del curso: sistema Big Data distribuido end-to-end que integra procesamiento batch, procesamiento streaming y analítica/ML con series de tiempo e inferencia.
Resultado esperado U3: el estudiante integra los componentes desarrollados en las unidades anteriores, prepara una demo end-to-end, valida resultados técnicos y analíticos, y sustenta una solución final orientada a la toma de decisiones. Por el alcance real trabajado, DataOps y BI quedan como proyección o mejora futura, no como componentes obligatorios de evaluación.
- Sesión 13: Integración del sistema.
- Sesión 14: Revisión técnica final y hardening.
- Sesión 15: Evaluación U3 / sustentación final con demo end-to-end.
- Sesión 16: Evaluación final de recuperación para estudiantes que no alcanzaron el nivel esperado o quedaron con calificación baja.
Arquitectura LambdaLab v2026-1
flowchart LR
    subgraph PySparkModule["uso pyspark"]
        direction TB
        Notebooks["notebooks/*.ipynb"]
        Jupyter["Jupyter<br/>localhost:4488"]
        Spark["Spark / PySpark<br/>localhost:4040"]
        Data["data/*.csv"]
        Artifacts["artifacts/"]
        Notebooks --> Jupyter --> Spark
        Data --> Spark --> Artifacts
    end

    subgraph UseFast["uso-rapido"]
        PyQuick["ec-orden-py<br/>publica / consume<br/>orden-eventos"]
    end

    subgraph UseMS["uso-ms-sb"]
        direction TB
        OrdenMS["ec-orden-ms<br/>API de ordenes<br/>publica orden-eventos"]
        OrdenDB["postgres ordenes dev<br/>localhost:49020"]
        PagoMS["ec-pago-ms<br/>API de pagos<br/>consume orden-eventos<br/>publica pago-eventos"]
        PagoDB["postgres pagos dev<br/>localhost:49030"]
        OrdenMS --> OrdenDB
        PagoMS --> PagoDB
    end

    subgraph UseIoT["uso-atmos"]
        IoT["pendiente"]
    end

    subgraph UseCDC["uso-replica-cdc"]
        CDC["pendiente<br/>MySQL -> Debezium -> Kafka -> PostgreSQL RAW<br/>migración / Spark BI-ML"]
    end

    subgraph KafkaModule["kafka"]
        direction TB
        subgraph KafkaStack[" "]
            direction TB
            Kafka["Apache Kafka<br/>kafka:9092<br/>localhost:49092"]
            KafkaUI["Kafka UI<br/>localhost:48085"]
            KafkaExporter["Kafka Exporter<br/>localhost:49308"]
            Kafka --> KafkaUI
            Kafka --> KafkaExporter
        end
    end

    subgraph ObsModule["obs"]
        direction TB
        subgraph ObsStack[" "]
            direction TB
            Prometheus["Prometheus<br/>localhost:49090"]
            Grafana["Grafana<br/>localhost:43000"]
            Prometheus --> Grafana
        end
    end

    PySparkModule -->|"U2: streaming consumer"| Kafka
    UseFast -->|"orden-eventos"| Kafka
    UseMS -->|"orden-eventos / pago-eventos"| Kafka
    UseIoT -. "futuro" .-> Kafka
    UseCDC -. "futuro: migracion CDC" .-> Kafka
    KafkaExporter -->|"métricas"| Prometheus

    style KafkaStack fill:transparent,stroke:transparent,color:transparent
    style ObsStack fill:transparent,stroke:transparent,color:transparent
Flujo de trabajo
- El alumno ejecuta los notebooks desde
pyspark/notebooks/usando el laboratorio local. - Spark lee datos desde
pyspark/data/y escribe resultados temporales enpyspark/artifacts/. - Los casos de uso publican y consumen eventos para simular flujos reales. Aquí, el equipo elige el stack Kafka:
kafka/para un entorno liviano sin CDC/Debezium, okafka-debezium/si necesita CDC/Debezium, Kafka Connect y mayor integración. - En los laboratorios de streaming, Spark consume eventos desde el broker
kafka:9092dentro de la red Docker y produce resultados para BI/ML. Desde el host, el mismo broker se accede comolocalhost:49092.
Arquitectura Uber
Uber maneja millones de eventos por segundo en tiempo real usando Kafka como columna vertebral de su sistema de datos. La siguiente imagen muestra cómo organizan el almacenamiento por niveles (tiered storage) para procesar pedidos, pagos y ubicaciones a escala global. Esta arquitectura inspira los conceptos que veremos en el curso: streaming, particionamiento, tolerancia a fallos y procesamiento distribuido.
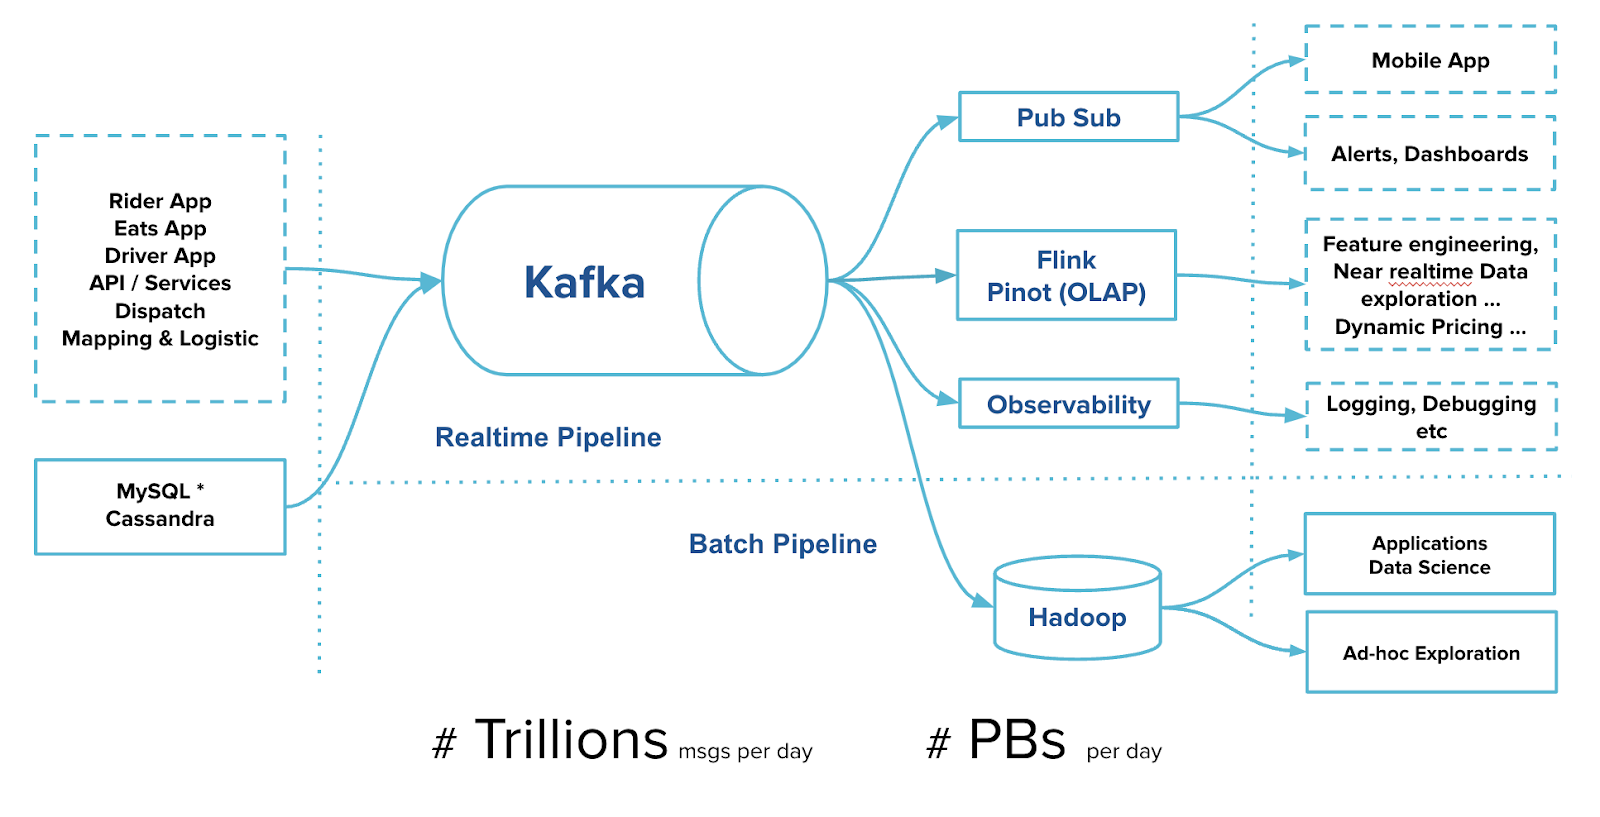
Fuente: Kafka tiered storage at Uber